
没显卡也能跑,加机器能扩:LocalAI 的后端按需装
想搬回内网,卡住你的可能不是显卡
把已经在跑的 AI 应用从云端挪回内网,多数人以为瓶颈是硬件,真正动手才发现难点在工程量:客户端里散落着几十处调用,SDK、流式响应的解析、错误重试的逻辑全都围着云端接口写,换一家就得重来一遍。LocalAI 的思路反过来——不动代码,动地址。它对外提供一套 OpenAI 兼容的接口,把现有客户端指向自己,请求照常发出、响应照常解析,只是这一次模型跑在你自己的机器上,数据从头到尾没有离开机房。
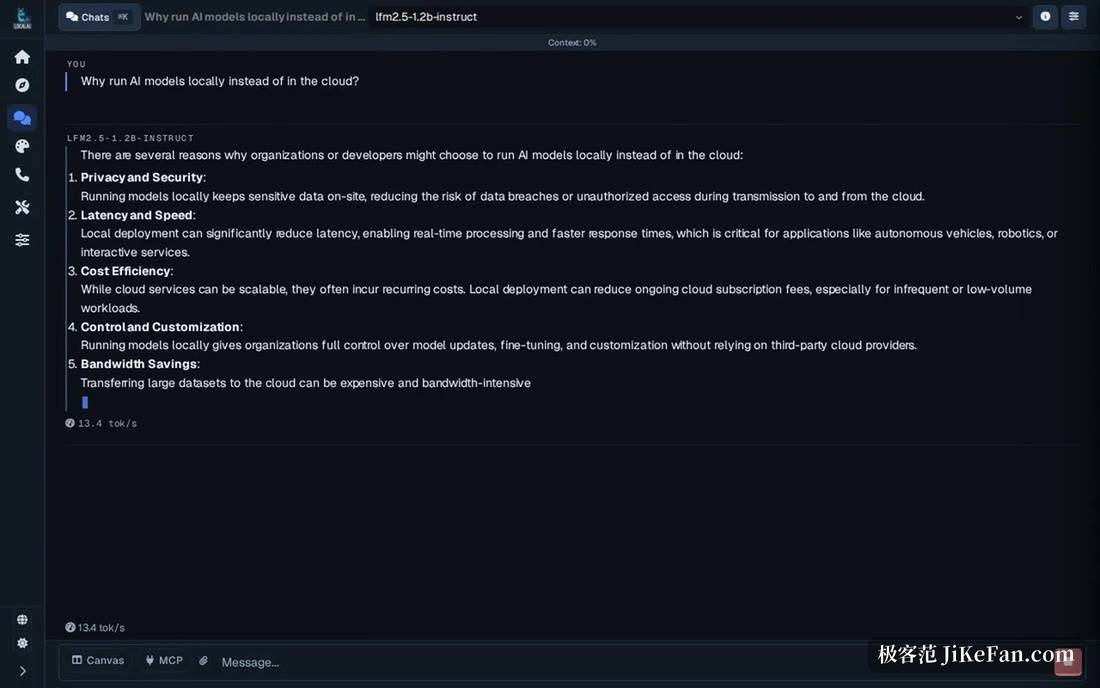
LocalAI 是一个开源的自托管 AI 运行时:一个二进制、一套 OpenAI 兼容接口,背后接什么引擎由你决定。
核心很小,引擎按需到位
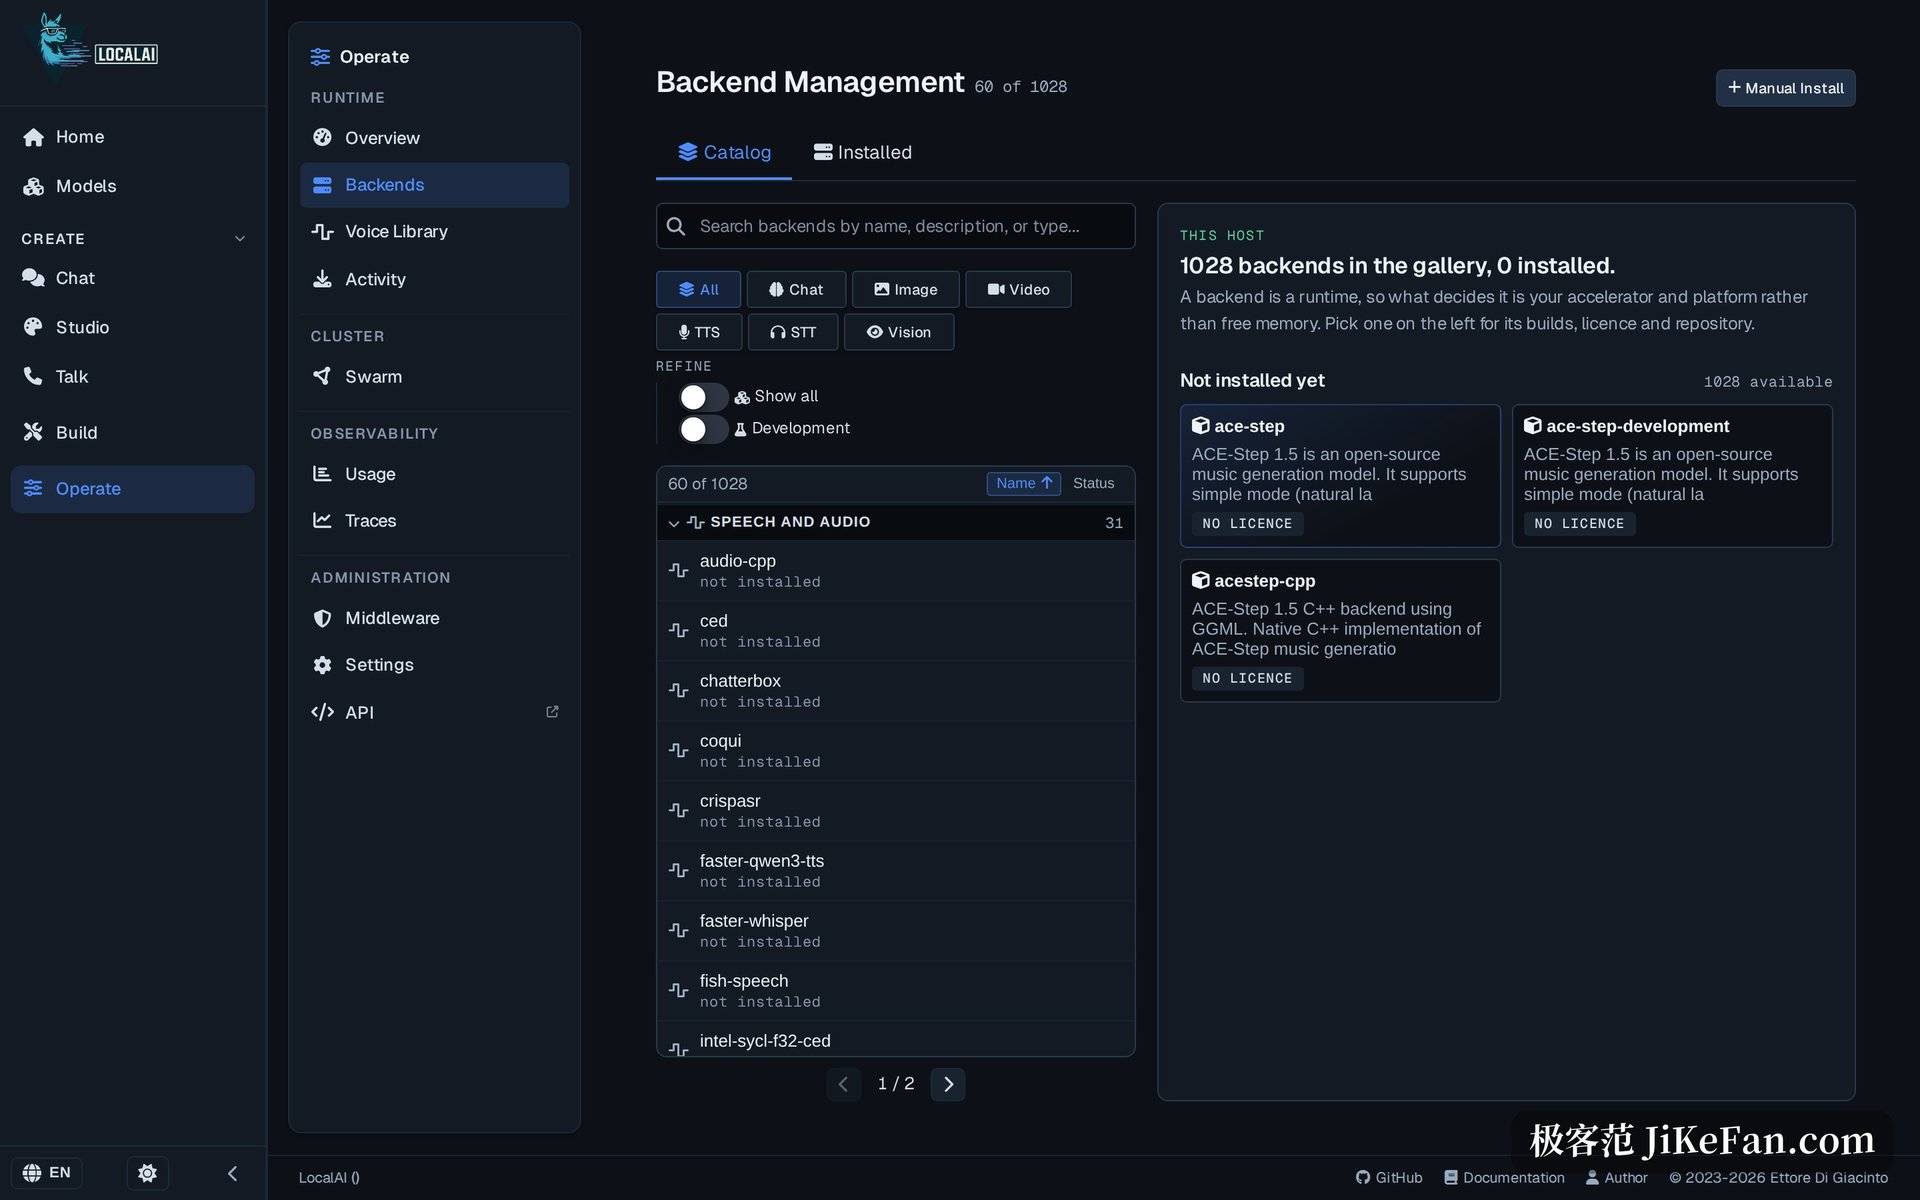
本地推理工具最容易被嫌弃的一点是臃肿:为了跑一个不大的模型,先要装下好几 GB 依赖,其中大半你可能一辈子用不到。LocalAI 把每种推理引擎都做成独立后端,以标准 OCI 镜像的形式分发,只有在某个模型真的需要它时才被拉下来。后端彼此隔离运行,可以单独安装、升级或移除,一个后端出问题不会拖垮其他服务,甚至能跑在另一台机器上。
这套设计带来一个直接好处:换引擎不用换接口。同一个服务端点下,一个模型可以跑在 llama.cpp 上,另一个走 vLLM、SGLang 或 MLX,客户端完全无感——请求格式不变,变的只是底层那一行配置。目前可选后端有六十多个,覆盖文本生成、语音识别与合成、视觉理解、图像与视频生成、嵌入与重排。硬件方面,NVIDIA、AMD、Intel、Apple Silicon、Vulkan 与 Jetson 都有对应的加速路径。
没有显卡,今天就能开始
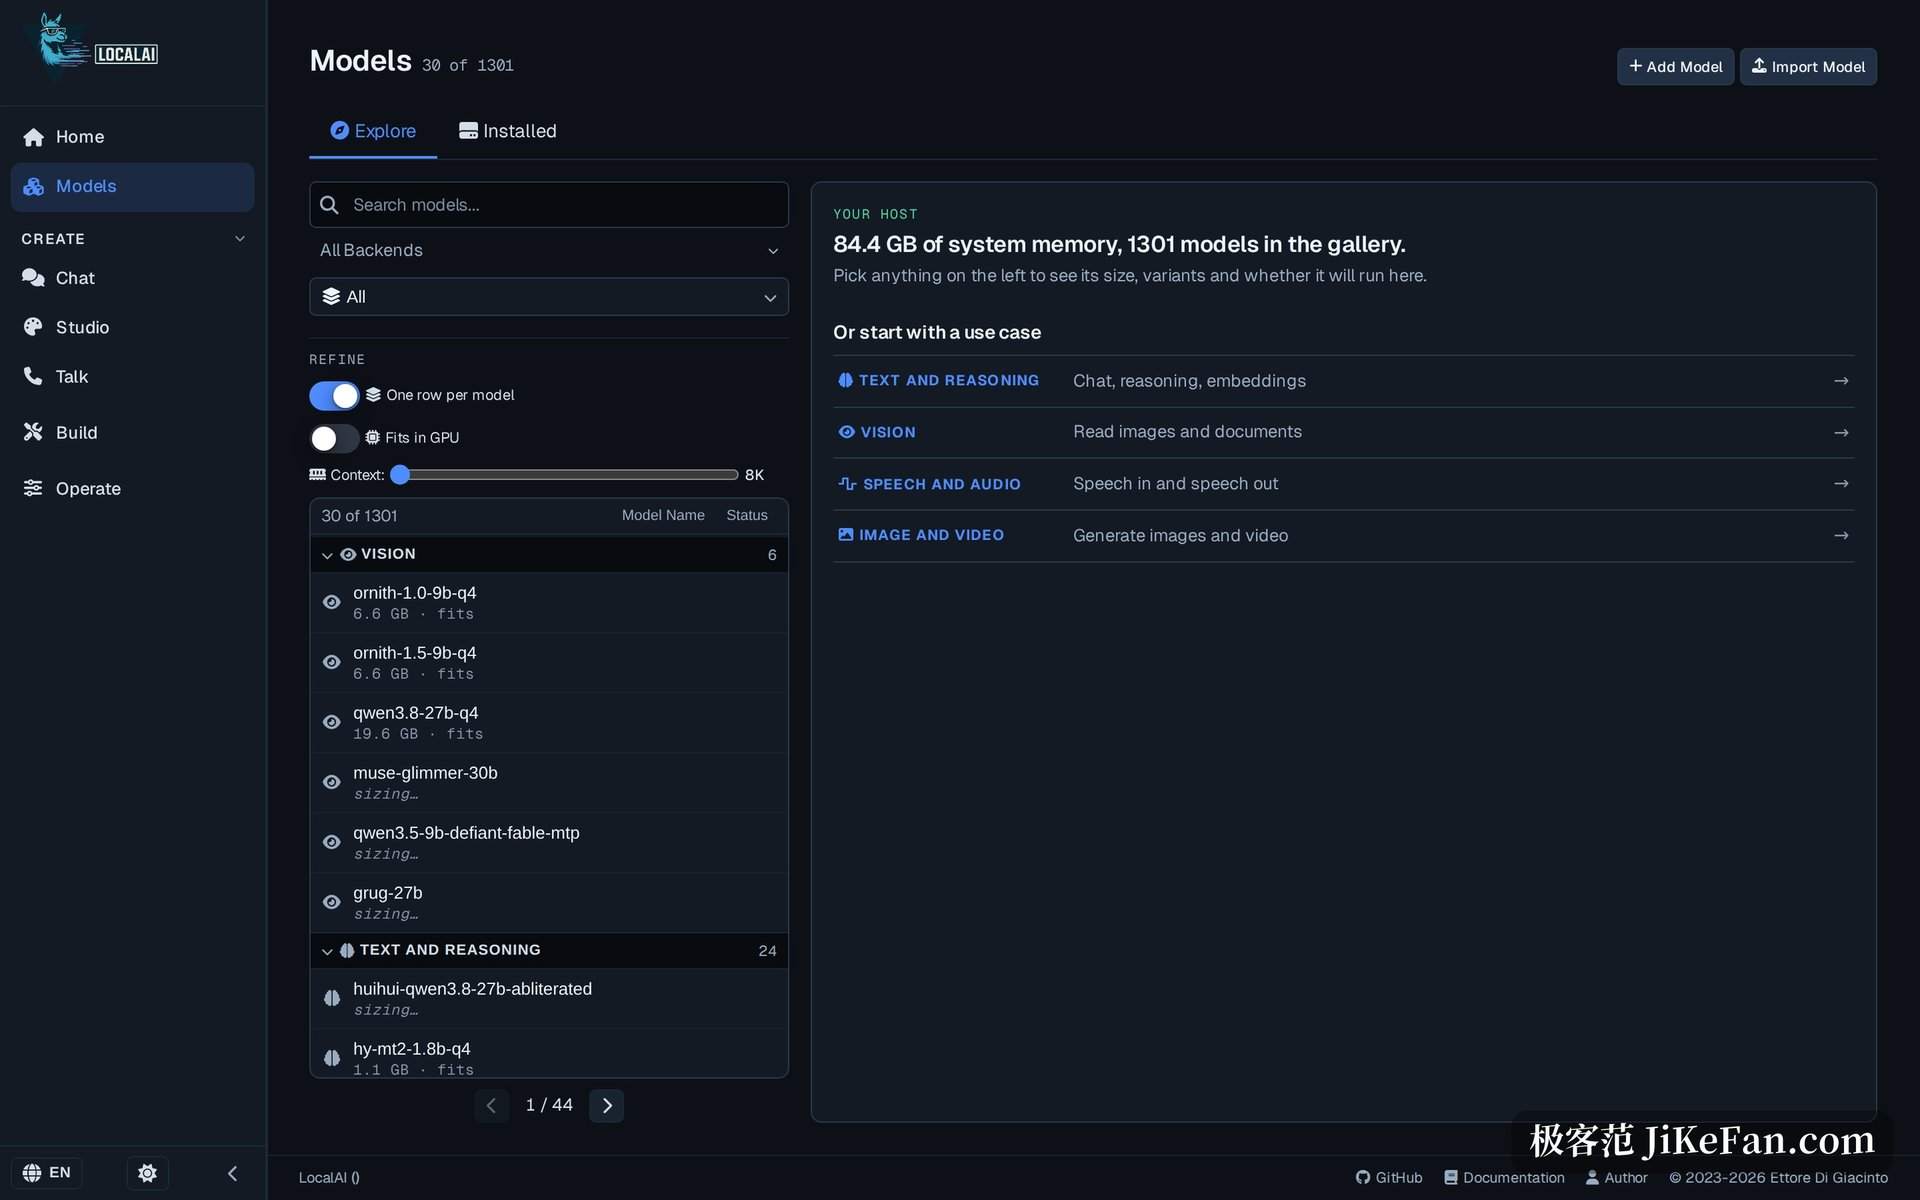
官方把一条原则写得很清楚:每个功能都先交付 CPU 路径,而且这条路径是在持续集成里、用普通人手头已有的硬件跑测试的,不是"能跑就行"的降级兜底。GPU 的作用是让它更快,而不是让它可用。对想先验证效果、再决定要不要采购显卡的团队来说,这个顺序很关键——先用现成的机器把流程跑通,再谈扩容。
如果模型本身大到装不下,还有量化这一步。项目自研的 APEX 方案会为不同张量、不同层分别选精度,把一个 35B 规模的混合专家模型从 64.6 GB 压到 12.2 GB,速度从每秒 30.4 token 提到 74.4 token,困惑度只是从 6.537 变成 7.088。压出来的是标准 GGUF 文件,原版推理引擎不用打补丁就能直接读。
机器变多之后,调度交给它
单机的天花板迟早会到。LocalAI 的做法是让你再添一台机器就行:请求路由、显存感知的模型放置、前缀缓存亲和、故障转移,这些原本要自己写调度的活,都由运行时接管。它既支持以 worker 节点横向扩展的生产模式,也支持点对点联邦组网——办公室里几台闲置机器拼起来,原本需要独显才敢想的任务就变得可行了。负载上来了就加机器,集群自己算怎么用。
除了聊天,它还在听和看
本地模型常被诟病只能打字,LocalAI 在这一层塞了不少东西:实时转写带说话人标签和时间戳,快到能跟上正在进行的会议;声音事件识别覆盖数百类,门响、玻璃碎、烟雾报警都能被注意到;声纹识别与人脸识别加上活体检测,能区分真人和举着的照片;用自然语言问"左边那个红色杯子",返回的是坐标而不是一句描述;从一张普通照片估算距离,用几张照片重建三维场景,都不需要相机标定,也不需要显卡。姓名、地址、卡号这类信息会在本机被识别并脱敏,在外发之前就处理掉。
后端按需拉取
核心保持精简,只在模型请求时才下载对应引擎
CPU 优先
每个功能都有经过持续集成验证的纯 CPU 路径
集群扩展
路由、放置与故障转移由运行时负责,加机器即可
升级前要留意的一处安全变更
4.9.0 版本把鉴权改成了默认拒绝。过去中间件靠匹配路径前缀判断哪些接口需要保护,不在列表里的就默认公开;而部分路由存在不带该前缀的别名,全局鉴权对它们并不生效,这一类绕过由安全研究者报告。现在中间件区分请求方法并默认拒绝,只有显式登记在公开注册表中的方法与路径才放行。如果开着数据库鉴权或旧式 API Key,升级后有两处变化要提前准备:版本信息接口开始要求凭据,生成的音频、图像、视频等资源的返回地址也需要带 Key 才能取。
想要的只是"把模型搬回自己机器上跑,最好别改代码"的话,LocalAI 给的是一条最短的路:换一个地址,剩下的交给它按需装配的引擎。