
海螺视频:官方称 H3 的 2K 单价不到主流模型三分之一
海螺视频是 MiniMax 的视频生成产品,中文站首页那句标题写得很直白:「海螺视频:每个想法都是一部大片」。当前主推的模型有两个——MiniMax H3 与 MiniMax H3 Max,官方公告条就写着「MiniMax H3 & H3 Max 上线」,同一行还挂着「新用户立即获得 3000 免费积分」的提示。工具区只有三类:视频 H3、图片、音频,加上「创作视频」「创作图片」与海螺 Agent 三个入口。
H3 是什么:一个统一理解四类模态的模型
MiniMax 官网对 H3 的定位只有一句:An open-weight, general-purpose, omni-modal generation model——开放权重、通用的全模态生成模型,官方还在研究条目上打了 Open Weights 标签。官方博文交代了它和前两代的关系:Hailuo 01 从零搭系统,Hailuo 02 打磨架构效率、数据质量与规模,而 H3 换了一条路——把过去被切成碎片的任务合起来。官方原话是,图像侧曾拆成文生图、编辑、主体参考、动作参考、风格参考各自的专家模型,音频侧人声、音效与音乐基本分开研究,视频侧又分成文生视频、图生视频、首尾帧、主体参考、动作参考、音色参考、视频编辑等一堆子任务,模态之间的边界同样清楚。这些隔断既限制了创作自由,也压住了模型泛化能力,所以跨任务统一与泛化成了 H3 的首要设计原则。
输出规格:768P 与 2K,最长 15 秒带原生立体声
官方博文首段给了三件事:H3 统一理解文本、图像、视频与音频的上下文;生成带原生立体声(native stereo sound)的视频;最长 15 秒、2K 分辨率,并且默认就是 2K。官方文档给出的规格表更细:H3 的输出分辨率为 768P 与 2K,时长 4 到 15 秒且只接受整数;H3 Max 由 MiniMax 与 AI 推理平台 fal 联合发布、在高速度上做了优化,输出 480P 与 768P、时长 5 到 15 秒。音频是这一代的重点之一——官方说明所有音频输出都是原生立体声,人声、音效与音乐不再分开建模,而是一起生成。
三种生成模式:从文生视频到参考生成
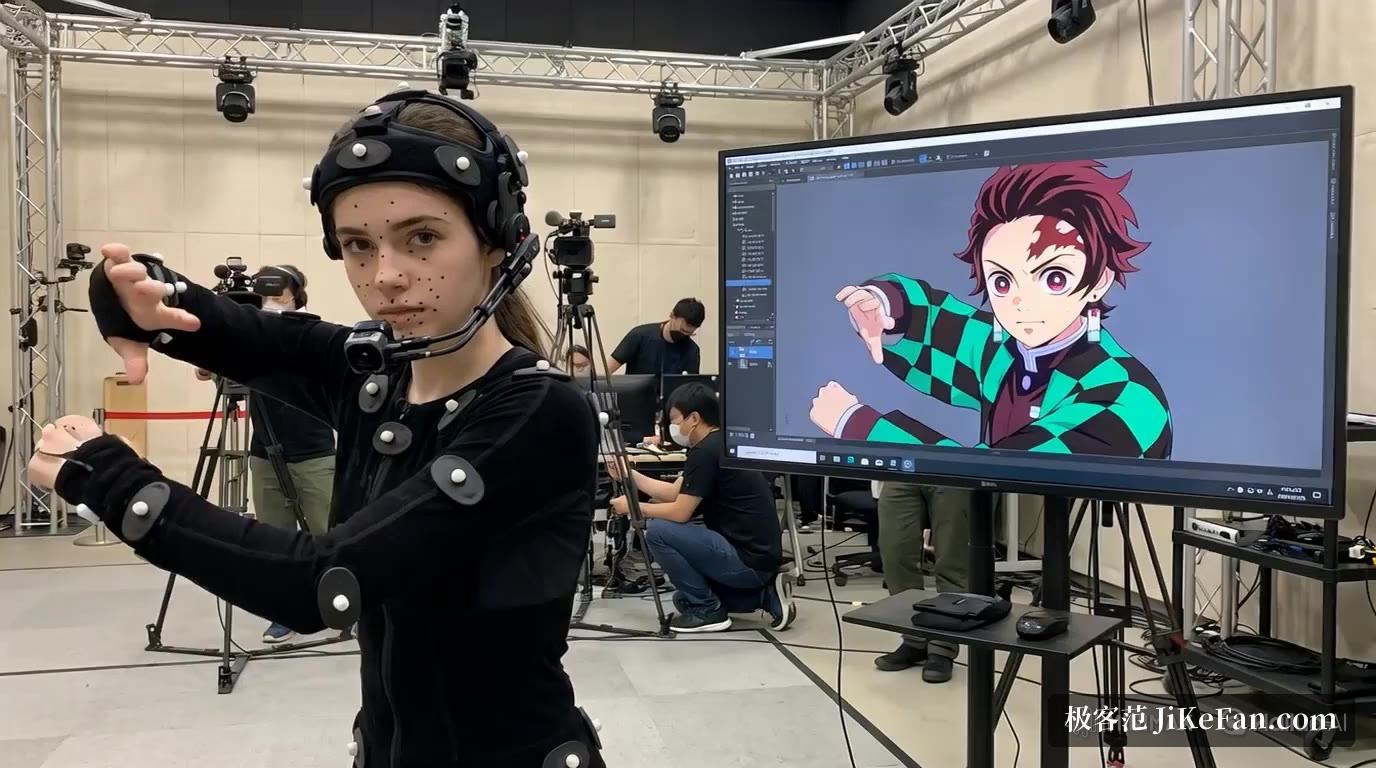
官方文档把能力归成三类。文生视频只要提示词,从零生成;图生视频支持首帧与尾帧图像,数量可以是 0、1 或 2 张,用来卡住开头或结尾那一帧,适合把一张静态图自然地动起来,也可以只给首尾帧让模型补中间;参考生成则是把参考图像、参考视频与参考音频混着用,用来锁定人物、动作、镜头、风格、音色或剪辑节奏。参考入口有明确的额度:图像不超过 9 张,视频不超过 3 段(每段 2 到 15 秒、合计不超过 15 秒),音频不超过 3 段,混合输入总计上限 12 个文件。
2K 不是超分出来的
H3 的 2K 输出方式值得单独讲。官方博文明确表示:针对 2K 输出,他们没有使用传统的专用超分模块,而是让 H3 基座模型在上下文中重新生成自己的低分辨率输出(In-Context Regeneration)。这样做有两个好处:一是最大化复用基座模型已经具备的生成能力;二是重生成时可以再次调用原始的多模态上下文,从而把传统超分只能「猜」、常常还原不出来的东西找回来——比如画面里的小字与精细纹理。配套的还有「视频重生成」通道:官方文档写明,如果手上已有符合 768P 输出规格的成片,可以提交重生成任务产出 2K,请求需要复现当初生成该 768P 视频的全部内容,并额外加一条源视频项。
H3-Context-IR:先把上下文读明白
多模态输入的复杂度容易超出手写提示词的表达能力,官方的解法是 H3-Context-IR 任务:它会深度解析文本、图像、音频与视频的多模态上下文,推理这些输入彼此之间的关系,产出一份语义更丰富的结构化表述。要注意的是这个接口只返回增强后的提示词,不生成视频——它是「生成前的翻译层」。背后的机制官方也讲了:H3 引入 Contextual Omni Representation,用语言作为可泛化的桥梁与解释器,把「任务」统一成开放的描述形式;其多模态理解管线会把大约 100K tokens 的原始素材蒸馏到平均约 4K tokens 再交给模型。
价格主张与订阅
官方博文对性价比的表述是:H3 默认提供 2K 分辨率,在 2K 下每秒价格不到主流模型的三分之一,在 768p 下不到主流模型 720p 价格的一半。这是官方口径,读者可以按自己的用量折算。面向个人用户,海螺视频中文站的价格提示是「低至 ¥42 每月」,国际站是「低至 $9.99 每月」,两站都表示新用户注册可获得免费积分——中文站写的是 3000 积分。
API 怎么调
视频生成是异步流程,官方文档分成三步:先创建生成任务拿到 task_id;再用 task_id 轮询任务状态,成功后响应会直接给出视频下载地址,不需要再换 file_id;最后从该地址下载视频。官方建议的轮询间隔是 10 秒,避免给服务器造成不必要的压力,状态为 failed 或 cancelled 就是终态失败。输入侧有几条硬限制值得先记住:提示词上限 7000 字符;单文件上限为视频 50 MB、图像 30 MB、音频 15 MB;请求体上限 64 MB,大素材建议直接传 URL;视频支持 H.264/AVC 与 H.265/HEVC,图像支持 JPG、PNG、WEBP、HEIC 等,音频支持 WAV 与 MP3。
几点边界
其一,开放权重目前是官方表述与计划:官网已把 H3 标注为 open-weight,博文写的是「计划在随后开放模型权重,并受适用法律法规约束」,落地版本以官方发布为准。其二,参考素材不是越多越好——混合输入总计上限 12 个文件,且中文站与国际站默认显示的参考上限不同,实际额度取决于所选模型与档位。其三,H3 与 H3 Max 的分辨率与时长规格不同(H3 为 768P/2K、4 至 15 秒;H3 Max 为 480P/768P、5 至 15 秒),选模型时要按成片要求对齐。其四,「2K 单价不到主流模型三分之一」是官方口径,第三方模型价格与活动随时变动,做预算建议以当期官网报价为准,并注意生成内容需遵守平台规范与相关法规。
一句话概括:海螺视频这一轮的看点不在「又一个文生视频入口」,而是 H3 把视频、图像与音频的理解合成一个上下文——默认 2K、最长 15 秒、自带原生立体声,2K 靠上下文中重生成而不是超分,参考素材上限给到 9 图 3 视频 3 音频,是它相对同类工具更实用的部分。