
F5-TTS:开源语音合成模型,代码是 MIT 许可而预训练模型限非商用
F5-TTS 是一篇论文的官方实现,论文标题起得挺俏皮——《F5-TTS: A Fairytaler that Fakes Fluent and Faithful Speech with Flow Matching》,直译过来就是「一个用流匹配伪造流畅忠实语音的说书人」。名字看着轻松,技术路线却不含糊:它用流匹配(Flow Matching)来做语音合成,骨干网络是 Diffusion Transformer 配合 ConvNeXt V2。
项目在 GitHub 上开源,已经发布过二十多个版本,仓库里同时维护着基础模型与推理、训练、部署相关的代码。
三个关键词:流匹配、ConvNeXt V2、Sway Sampling
官方在项目说明里把三件事并列写成要点。第一件是 F5-TTS 本身——用 Diffusion Transformer 搭配 ConvNeXt V2,官方原话是「训练与推理都更快」。第二件是 E2 TTS,一个采用 Flat-UNet Transformer 结构的复现版本。第三件是 Sway Sampling,一种推理阶段的流步采样策略,官方称它能明显改善生成表现。
对使用者来说,前两点决定了模型的能力上限,第三点决定了同一个模型能跑出什么效果。Sway Sampling 属于推理期就能生效的调整,不需要重新训练,这是它被单独列出来的原因。
装起来:一行 pip,或者换成 Docker
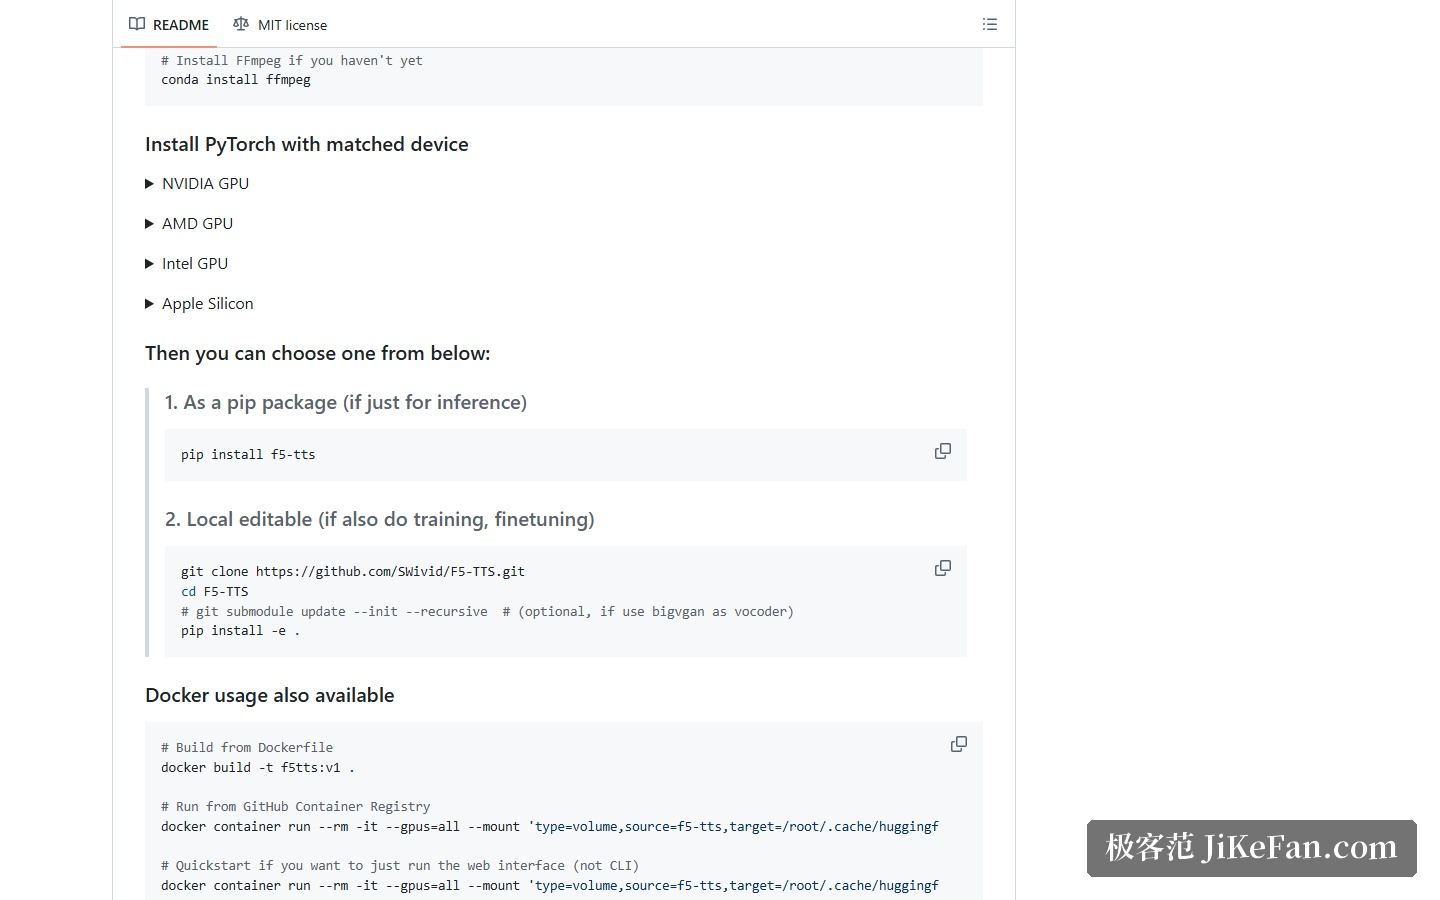
官方把安装方式分成两类,取决于你想做什么。只做推理的话,直接装 pip 包就够了;要训练或者微调,就得把仓库克隆下来做可编辑安装。装 PyTorch 之前需要先按自己的设备选版本,官方分别给出了 NVIDIA、AMD、Intel 和 Apple Silicon 几种平台的安装命令。
除此之外还有 Docker 这条路:既可以自己用仓库里的 Dockerfile 构建,也可以直接拉官方镜像跑起来,官方甚至给了一条只启动网页界面的快捷命令。
三种用法:命令行、网页界面、语音对话
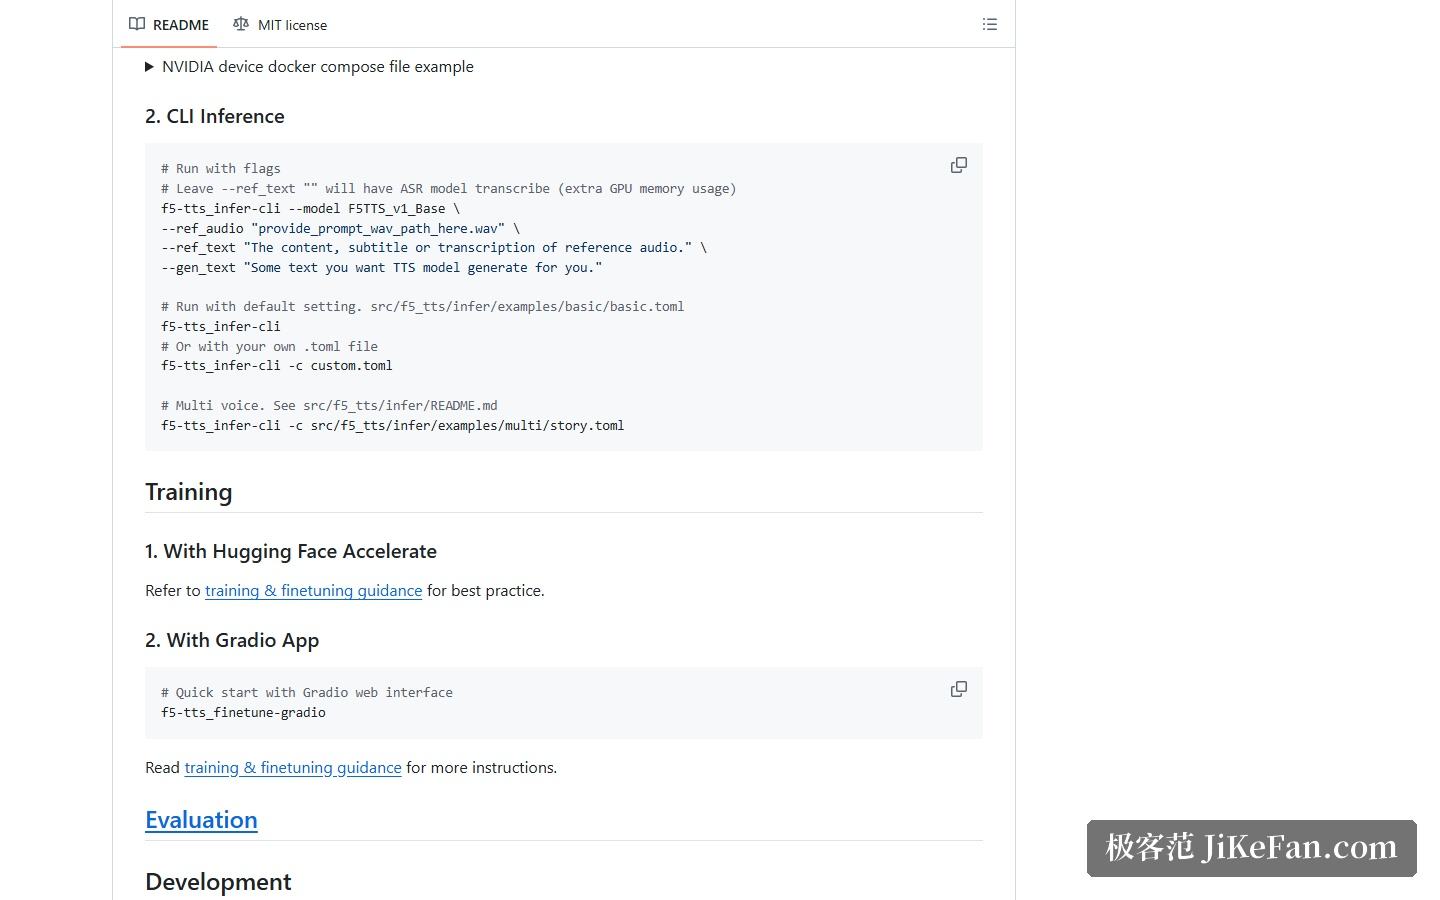
命令行工具的参数很直观:给一段参考音频、给出这段音频对应的文本,再写一句想要生成的文本,模型就会用参考音频的音色把目标文本读出来。官方还提到一个细节——参考文本可以留空,此时会调用语音识别模型自动转写,代价是多占一些显存。
如果不想碰命令行,可以启动 Gradio 网页界面。官方列出的功能包括基础语音合成、多风格与多说话人生成,以及一个由 Qwen2.5-3B-Instruct 驱动的语音对话功能。也就是说,这个界面不只是把文字转成音频,还能做一轮语音形式的对话交互。
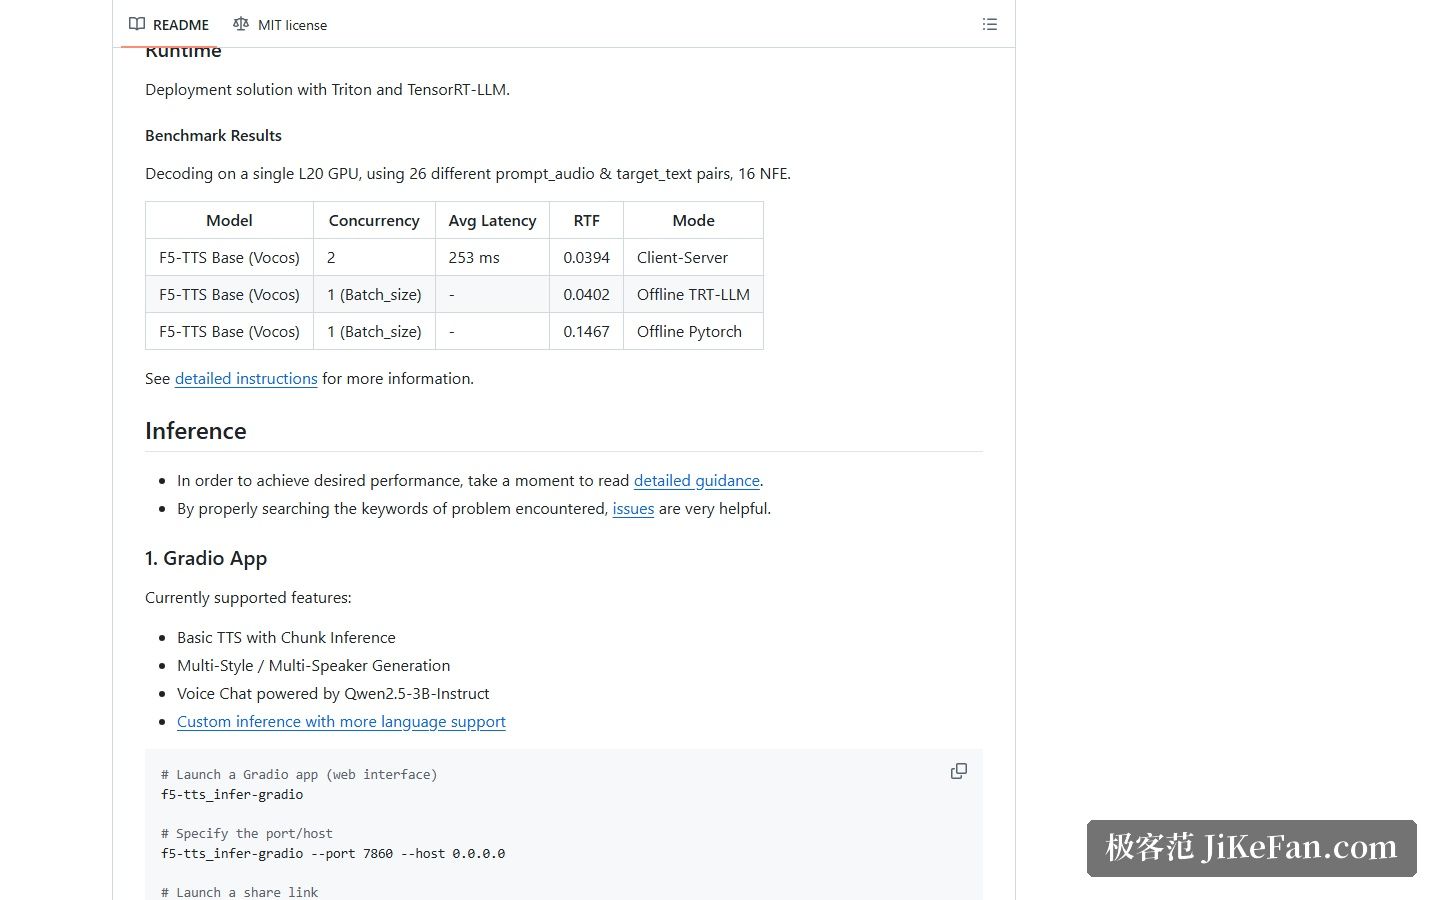
性能数据:单张 L20 上跑出来的结果
官方在部署方案一节给出了基准测试,测法是单张 L20 显卡、26 组不同的参考音频与目标文本配对、16 步推理。F5-TTS Base 在并发为 2 的客户端-服务端模式下,平均延迟 253 毫秒,实时率约 0.0394;换成离线 TensorRT-LLM 模式实时率是 0.0402,而离线 PyTorch 模式则为 0.1467。实时率越低意味着生成速度快于播放速度的倍数越多,从这组数据也能看出不同部署方式的差距。
训练与微调
项目同样把训练路径分成两条:一条走 Hugging Face Accelerate,适合常规的训练与微调;另一条是 Gradio 界面,官方给了一个专门的微调界面启动命令,不用写代码就能跑起来。对只想把模型调成自己想要的音色的使用者,后一条路更省事。
许可:代码 MIT,模型非商用
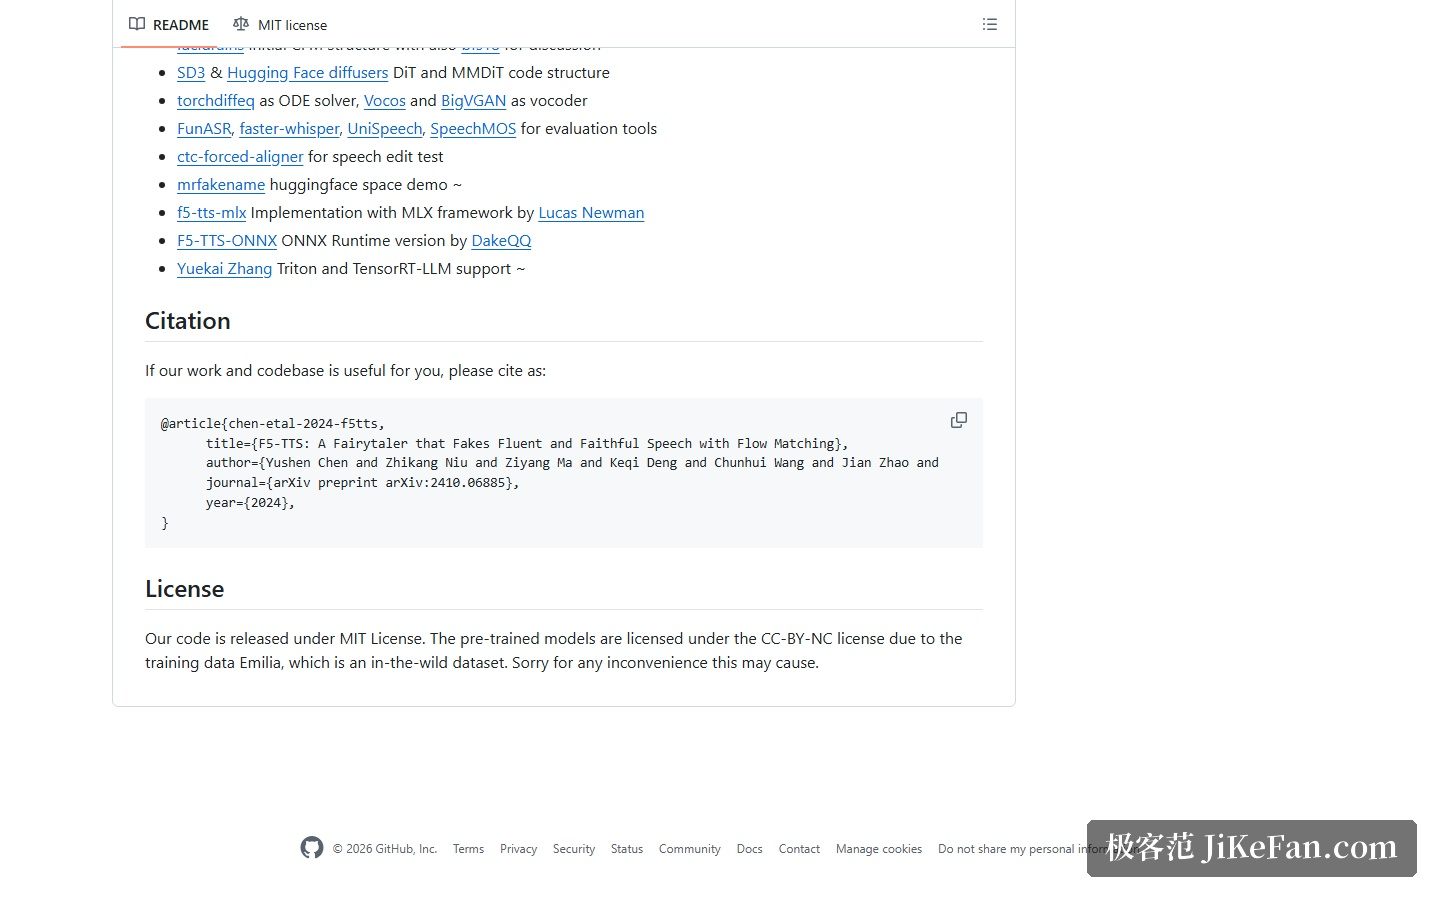
这一段需要看得仔细一点。官方在许可证一节写明:代码以 MIT 许可证发布,但预训练模型的许可不同——因为训练数据 Emilia 属于野外采集数据集,所以预训练模型采用的是 CC-BY-NC 许可证,也就是限制非商业用途。官方在原文里也为此道了歉。
这意味着你可以自由地用这套代码做二次开发,但如果打算把官方预训练模型直接用在商业项目里,就有许可上的障碍。要绕开这一条,通常得换成许可更宽松的数据集自行训练,而这需要额外的算力与数据准备。
它适合谁
如果你是研究者、开发者,想在一个结构清晰、迭代活跃的开源语音合成项目上做实验,F5-TTS 的代码质量与文档完整度都不错:安装方式多、部署方案给了 Triton 与 TensorRT-LLM、推理和训练都有现成入口。
如果你只是想找一个能直接商用的语音合成方案,那要先解决许可证的问题,或者评估自训练的成本。另外,无论用哪个模型,声音克隆的授权边界都值得先确认清楚——用别人的声音做内容,尤其是公众人物的声音,可能涉及人格权与声音权。
开源项目把能力摆出来了,也把限制写在了许可证那一节。用之前花两分钟读一遍许可条款,往往比事后返工划算得多。