
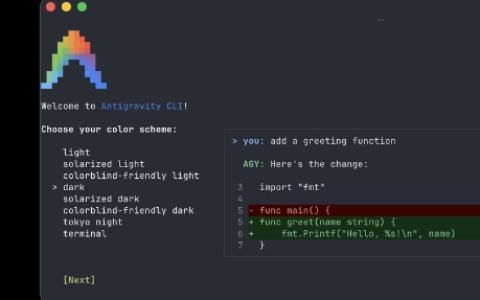
谷歌用 Go 重写的新一代终端 AI 智能体,接棒 Gemini CLI:单文件安装,与桌面端共用同一套智能体内核,支持子智能体并行与终端沙箱,个人使用 0 美元起步。
OpenAI 开源的终端编码 agent:默认关掉网络访问、写操作只限工作目录,改文件跑命令先过审批。Rust 重写后是一个静态二进制,还能用 codex exec 塞进流水线。
Anthropic 的 Claude Code 把编码 agent 放进终端,代码不出本机直连模型,读库、改文件、提 PR 前先请求许可,并支持多会话与并行子代理。
Windsurf 更名为 Devin Desktop 后,把本地与云端 agent 收进同一块看板,并以开放协议让第三方与自研 agent 也能挂进来。
GitHub Copilot 让改动自己走完建分支、提交、开 PR 与评审前的自查这一段流程:派一个 issue 给它,回来就是一条待审的拉取请求,并可并行多个会话。
Cursor 是一款把自己定位成编码智能体的 AI 编辑器:改动牵涉十几个文件时,它会自己读完整库、拆解任务并并行交给子智能体,更大的工程则由协调者统一规划与分派。
LocalAI 是开源的自托管 AI 运行时,用 OpenAI 兼容接口把模型搬回自己的机器,后端按需加载、无显卡也能跑,还能扩展到多机集群,适合想做本地私有化部署的开发者。
装 ComfyUI 不再需要配环境:MIT 开源的 Pinokio 把三百多个本地 AI 应用做成应用商店,点一下 Install 自动下载模型、配置依赖、启动服务,隔离环境互不干扰,玩腻直接删。
把操作系统管理内存的分页机制搬进显存,vLLM 用 PagedAttention 让 KV Cache 利用率从三四成提升到九成以上,同一块 GPU 并发翻倍——再加上 OpenAI 兼容 API 与连续批处理,自建大模型服务从实验走向生产就靠它。
内置 MLX 与 llama.cpp 引擎一键跑本地模型,12+ 云端提供商随时接入,对话中途换模型不用换窗口——Split Chats 把模型对比变成并排聊天,知识栈把 RAG 压缩成拖入即问。
把 PDF、Word、CSV 拖进工作区,就能得到一位读过你全部资料的 AI 助手——每条回答带引用标注,模型、向量库、存储全部默认本地运行。MIT 开源的 AnythingLLM 让私有 AI 工作台真正数据不出机。
纯 C/C++、零依赖的 llama.cpp 定义了 GGUF 量化格式,让没有显卡的电脑也能跑本地大模型。CUDA、Metal、Vulkan 全后端覆盖,llama-server 提供 OpenAI 兼容 API,是 Ollama 与 LM Studio 身后的那台引擎。
不需要显卡、不需要账号、不需要命令行:MIT 开源的 GPT4All 让普通电脑用 CPU 就能跑本地大模型,LocalDocs 把私有文档问答变成一个勾选项,数据全程不出本机。
一款 Apache 2.0 开源的本地 AI 助手:模型下载后断网照常对话,数据不出本机,代码全部公开可查,还能接云端模型、开本地 API、连 MCP 工具。
不用碰终端,点几下就能在本地跑开源大模型:Hugging Face 模型浏览器、类 ChatGPT 聊天界面、OpenAI 兼容 API 一站配齐,个人与商用全免费,数据不出本机。